引言:从“模型调用”到“模型治理”的范式转移
随着生成式AI从技术探索走向规模化应用,企业正面临一个前所未有的复杂局面:内部自研模型、外部闭源API、开源社区模型、以及各类垂类专用模型交织并存。技术决策者们很快发现,简单地接入一两个主流模型API,远不足以支撑起一个健壮、高效且成本可控的企业级AI能力体系。
一个典型的场景是:业务团队A为了追求极致性能,直接调用Claude API;团队B出于成本考虑,选择了GPT-3.5-Turbo;而数据科学团队C则在自己的Kubernetes集群上部署了Llama 3。这种“烟囱式”的模型调用模式,迅速带来了API密钥管理混乱、成本黑洞、性能监控缺失、供应商锁定风险加剧等一系列治理难题。
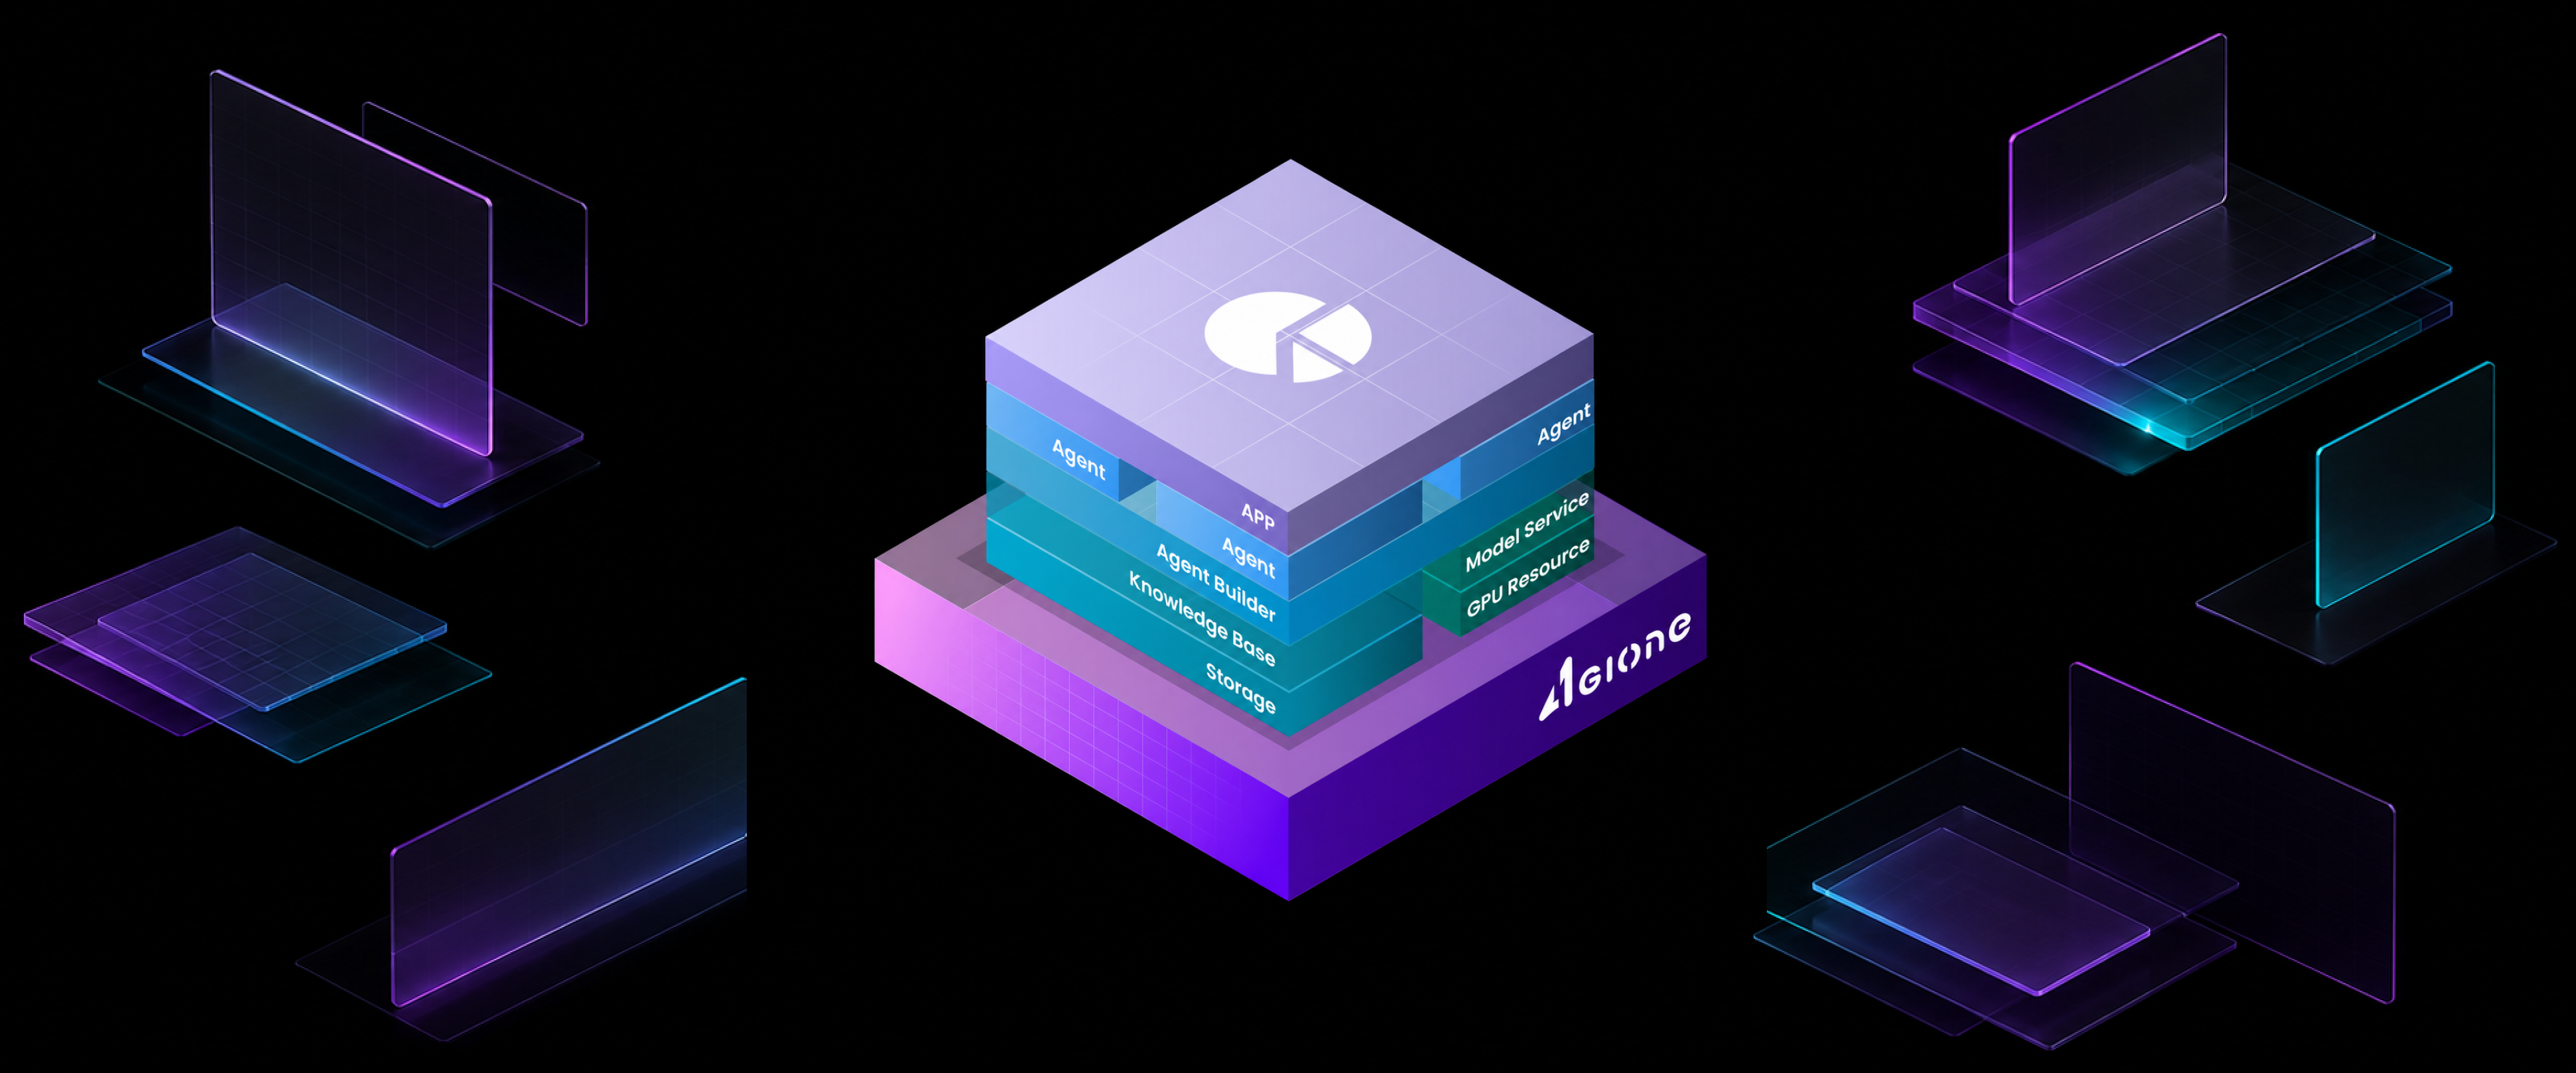
行业趋势清晰地指向了专业化分工:模型服务层(Model Serving Layer) 正从通用AI平台或单一模型供应商的附属功能中解耦出来,成为一个独立且关键的技术栈。本文将深入剖析通用平台在模型聚合治理中的固有局限,并揭示为何一个专业的模型路由与聚合平台,如AGIOne ModelOne(模创),正成为企业构建可持续AI能力的基石。
一、 行业现状:AI模型服务专业化趋势下的挑战
当前,企业引入AI模型主要面临三大趋势,这些趋势共同催生了模型服务专业化的需求:
1. 模型来源多元化与碎片化:企业不再依赖单一供应商。闭源模型(如GPT-4、Claude 3)、开源模型(如Llama、Qwen)、行业专用模型以及自研微调模型,共同构成了一个异构的“模型矩阵”。每种模型在协议、参数、计费方式和性能表现上各不相同。
2. 应用场景对模型需求的差异化:同一企业内部,不同场景对模型的要求天差地别。客服对话需要高可用性与低延迟,代码生成追求长上下文和强逻辑性,内容创作则看重创造性与风格一致性。没有“一招鲜吃遍天”的模型。
3. 成本、性能与稳定性的三角博弈:模型调用成本(尤其是Token成本)已成为可观的OPEX。同时,响应延迟(Latency)、吞吐量(TPS)和服务可用性(SLA)直接关系到用户体验和业务连续性。企业需要在三者之间根据实时情况进行动态权衡。
面对这些趋势,许多团队的第一反应是求助于现有的“通用平台”,这通常指:
· 云厂商提供的AI模型市场或统一API。
· 开源API网关(如Kong, APISIX)进行简单的代理和鉴权。
· 自研一个简陋的“模型中间层”脚本。
然而,这些通用方案在应对上述专业化挑战时,往往力不从心,甚至引入新的复杂度。
二、 痛点分析:通用平台在模型聚合与治理中的五大局限
将通用平台或临时方案用于模型治理,如同用瑞士军刀进行精密外科手术,虽能解决部分表面问题,但深层次的结构性缺陷会逐渐暴露。
局限一:缺乏真正的“策略化路由”能力,无法实现智能调度
通用API网关的核心能力是流量转发,而非智能路由。它们可以根据URL、Header进行简单的路由,但无法基于模型服务的实时状态、业务场景的成本/性能偏好进行动态决策。
· 场景示例:一个聚合了GPT-4和成本更低廉的Claude Haiku的“文案生成”服务。通用平台通常只能做固定权重或主备切换。而专业路由需要能实现:在非高峰时段,为内部创意团队路由至效果更优的GPT-4;在高峰促销期,为海量商品描述生成自动切换至成本优先的Claude Haiku;当某个模型API错误率超过阈值时,自动无缝切换到备用模型。
· AGIOne ModelOne的对应能力:其策略化路由调度功能支持配置性能优先、成本优先、可用性优先及自定义策略。它能实施监测模型状态,基于错误率阈值触发自动故障切换,并支持多模型加权分发,实现了从“静态代理”到“动态调度”的跨越。
局限二:模型“聚合”能力薄弱,逻辑模型抽象缺失
通用平台通常将每个物理模型视为一个独立的端点(Endpoint)。业务方需要感知后端具体是哪个模型、地址是什么。这违背了“模型即服务”(MaaS)的抽象原则。
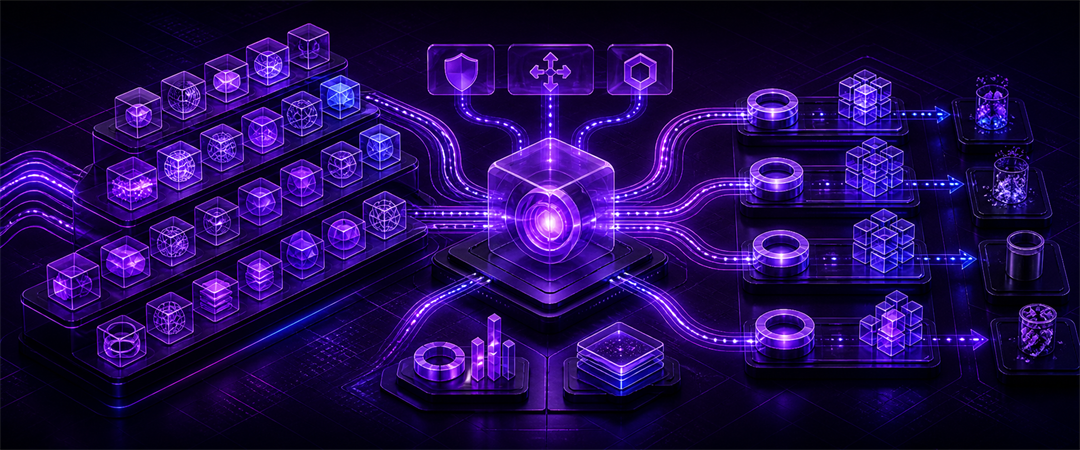
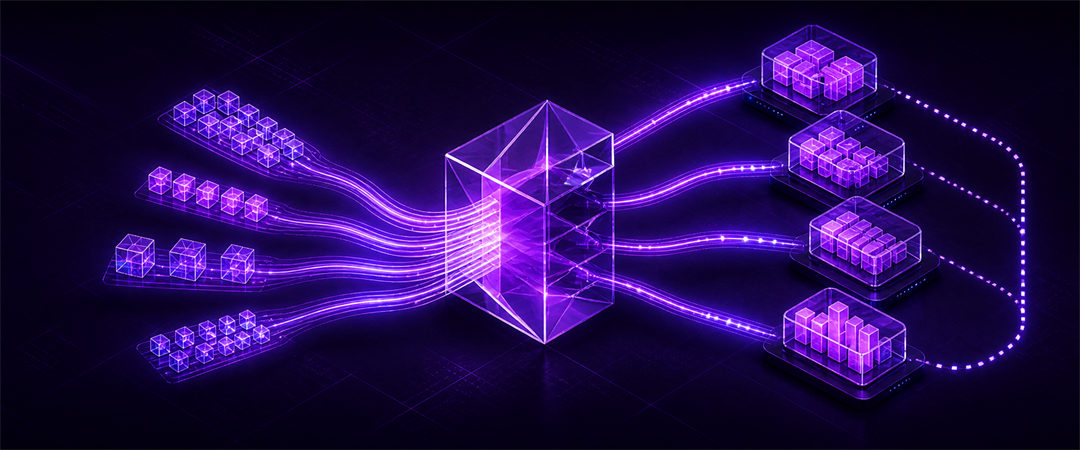
真正的聚合是将多个物理模型的能力,封装成一个逻辑模型对外提供服务。调用方只需与这个逻辑模型交互,无需关心背后是单个模型还是多个模型的组合,以及如何组合。
· 场景示例:提供一个“代码助手”逻辑模型,背后可能根据代码语言(Python/JavaScript)、复杂度(简单补全/架构生成)自动路由至CodeLlama、GPT-4或DeepSeek-Coder。对开发者而言,他只有一个统一的/v1/code/completion接口。
· AGIOne ModelOne的对应能力:其聚合模型能力允许将多个来源模型聚合发布为一个逻辑模型,支持权重分配和策略规则配置,最终提供一致化的接口输出。这解决了“在不同场景下对成本、性能、稳定性的差异化要求”。
局限三:可观测性(Observability)维度单一,难以进行精细化运营
通用平台的监控大多停留在HTTP状态码、延迟、QPS等基础设施层面。而对于模型服务,关键指标远不止这些:
· 模型层指标:各模型的Token消耗速率、输入/输出Token分布、每次调用的实际成本。
· 质量与效果指标:响应内容的合规性筛查(需对接审查服务)、错误类型分布(如速率限制、内容过滤、模型过载)。
· 业务维度统计:按部门、项目、应用拆分的使用量和成本。
缺乏这些维度的可观测性,成本管控和效能优化就无从谈起。
· AGIOne ModelOne的对应能力:其模型服务网关提供了专门的可观测能力,包括详细的调用日志、成功率统计、使用趋势分析及用户行为统计。结合其计量与结算功能,能够按模型、按用户进行多维度的使用数据分析和成本归因。
局限四:计量与结算体系缺失,造成成本失控
直接调用模型API,成本分散在各个云账户和API密钥下,财务部门难以统一核算和预算管控。通用平台通常不具备原生的、与模型调用深度集成的计量计费能力。
企业需要一套统一的“计量-扣费-结算”体系,将模型消耗转化为内部可核算的成本单元。
· 场景示例:开发团队使用模型服务,应像使用云资源一样,有清晰的配额、预算和实时成本展示。模型提供方(无论是外部供应商还是内部团队)也能基于明确的计量规则获得收益或成本分摊。
· AGIOne ModelOne的对应能力:它构建了完整的积分体系和结算机制。支持按Token、调用次数、时长等多种方式计量,自动扣费。实现了使用方与平台的线上结算,以及平台与供应方的线下结算闭环,提供了商业化运营的基础设施。
局限五:模型与算力割裂,无法实现端到端优化
模型服务最终要运行在算力之上。通用平台往往只管理“服务调用”,不关心“服务部署”。当自研或开源模型需要扩缩容、升级版本或迁移环境时,需要手动协调基础设施团队,流程割裂,效率低下。
· AGIOne ModelOne的对应能力:其 “模·算”联动部署能力是关键差异化优势。在发布模型时,可选择直接接入已有API,或联动其算力纳管子平台(算模方)进行一键部署。这实现了模型部署状态同步、算力资源监测、弹性扩展支持以及算力成本数据反馈,打通了从模型到算力的最后一公里。
三、 解决方案:AGIOne ModelOne如何通过路由与治理实现高效模型服务
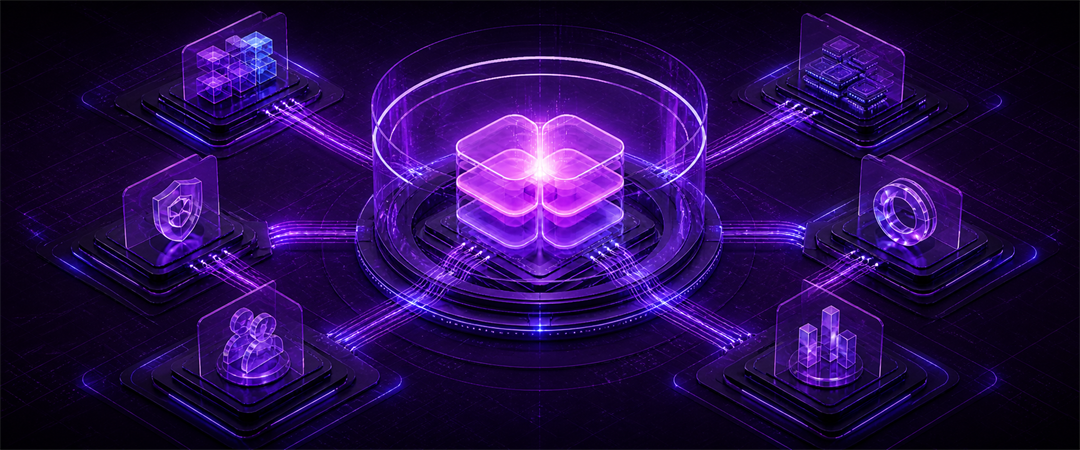
AGIOne ModelOne(模创)将自己定位为“模型及AI服务层平台”,其核心设计哲学正是为了解决上述通用平台的局限。它通过四大核心支柱,构建了一个专业的企业级模型治理框架。
支柱一:统一接入与标准化封装 —— 消除异构性
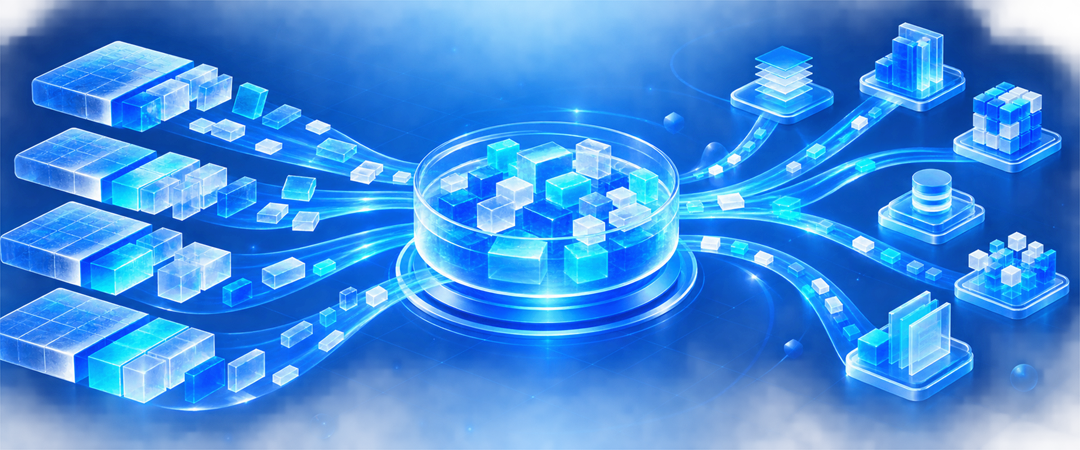
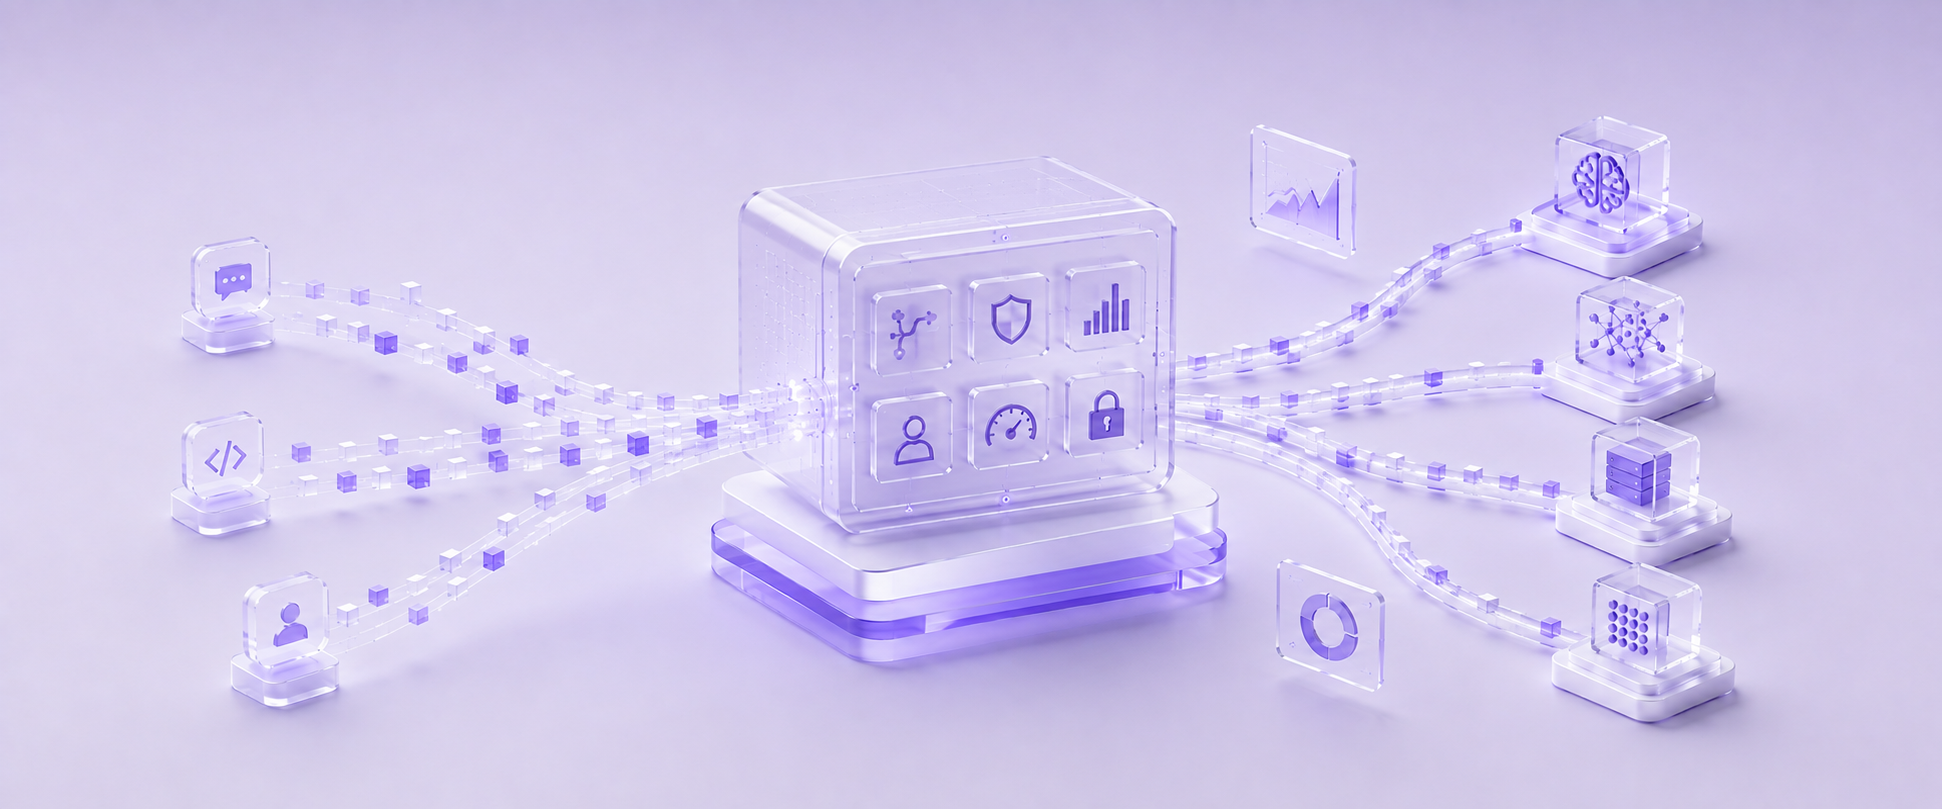
首先,ModelOne通过API协议适配和参数结构映射,将不同来源(公共云、私有化部署)、不同协议、不同参数格式的模型,统一封装成平台内部的标准格式。无论是OpenAI格式、Anthropic格式还是自定义格式的模型,对平台使用者而言,都通过一致的RESTful API进行调用。
这为后续的所有高级功能奠定了基础,实现了技术栈的“去供应商锁定”。
支柱二:策略化路由调度 —— 智能流量指挥官
这是ModelOne的大脑。它允许管理员为聚合模型配置复杂的路由策略:
· 成本优先:在效果可接受的范围内,自动选择每次调用成本最低的模型。
· 性能优先:根据实时监控的延迟数据,选择响应最快的模型端点。
· 可用性优先:结合健康检查,确保请求总能被可用的模型实例处理。
· 自定义策略:可以结合业务属性(如用户等级、任务类型)进行路由。
· 冗余与熔断:设置错误率阈值,实现自动故障切换和熔断,保障整体服务SLA。
动态调度引擎会持续评估各模型实例的状态,执行这些策略,确保流量以最优方式分发。
支柱三:服务网关与全链路可观测 —— 管控与洞察之门
ModelOne内置了一个功能强大的API网关,提供企业级必需的控制平面:
· 统一入口与鉴权:一个Endpoint服务所有模型,通过API Key进行统一的身份验证和权限控制。
· 精细化流量控制:支持用户级和模型级的限流(QPS管控),配备峰值保护机制,防止意外流量打垮后端模型服务。
· 深度可观测:如前所述,它记录的日志和指标是模型服务专属的,为故障排查、性能优化和成本分析提供数据支撑。
支柱四:计量运营与生态闭环 —— 实现模型即服务
ModelOne不仅仅是一个技术平台,更是一个运营平台。它通过内置的积分体系,将模型调用量化:
1. 使用方:充值积分,调用模型时按预设规则(如按Token)自动扣费,消费透明。
2. 供应方:提供模型,根据被调用量获取积分收益,实现能力变现或内部成本分摊。
3. 运营方:管理整个平台的模型上架、审核、结算规则,构建内部或对外的模型市场。
这套机制使得模型在企业内部真正成为可管理、可运营、可计费的“服务产品”。
四、 案例启示与最佳实践:构建企业模型服务层的关键路径
基于AGIOne ModelOne的能力框架,我们可以提炼出企业建设专业模型服务层的最佳实践。
最佳实践一:确立“逻辑模型”抽象,解耦应用与模型实现
· 做法:不要让业务应用直接绑定具体的物理模型API。通过ModelOne创建代表业务能力的逻辑模型(如“通用对话”、“文本总结”、“代码生成”),将具体的模型实现和路由策略封装在后端。
· 收益:当需要更换、升级或增加后备模型时,业务应用无需任何改动,实现了敏捷迭代和降本增效。
最佳实践二:实施基于场景的精细化路由策略
· 做法:深入分析不同业务场景的优先级。例如,面向C端用户的在线服务配置“可用性优先+性能优先”策略;内部数据分析任务配置“成本优先”策略;并为所有关键逻辑模型配置至少一个备用模型和故障切换规则。
· 收益:在保障核心业务体验的同时,最大化资源利用率,整体优化TCO(总拥有成本)。
最佳实践三:建立统一的模型计量与成本归因体系
· 做法:利用平台的计量能力,为每个部门、项目团队设立模型调用预算和配额。定期生成成本报告,按模型、按团队进行成本分析。
· 收益:终结成本黑洞,培养团队的资源成本意识,为财务规划和资源采购提供精准数据支持。
最佳实践四:实现模型生命周期的自动化联动
· 做法:将ModelOne与内部的CI/CD流水线和算力管理平台(或利用其“模算联动”能力)打通。当新模型版本通过测试后,可自动部署到算力平台并注册到ModelOne,通过蓝绿或金丝雀发布策略逐步引流。
· 收益:极大缩短模型从开发到上线的周期,提升交付效率,并降低人工操作风险。
最佳实践五:构建可观测性驱动的高效运维
· 做法:不仅监控平台级指标,更要定制业务关键指标(如平均每次调用Token数、成本异常波动、特定错误码突增)。设置告警,并建立从告警到排查(查看具体失败请求日志)到解决的SOP。
· 收益:变被动救火为主动预防,提升模型服务的整体稳定性和运维团队效率。
结论:专业路由平台——企业AI能力进化的必然选择
在AI模型服务领域,“通用”往往意味着妥协和局限。当企业的模型应用进入深水区,从零星尝试转向规模化、生产化部署时,对专业化治理工具的需求就会变得迫切。
AGIOne ModelOne这类专业模型路由与聚合平台的价值在于,它提供了一个集中化、智能化、可运营的模型服务控制平面。它不仅是技术的聚合器,更是策略的执行者、成本的守门员和运营的支撑台。
面对纷繁复杂的模型服务乱局,企业技术领导者应当超越简单的API调用思维,从架构层面规划一个专业的模型服务层。这不仅是解决当前痛点的方案,更是为未来容纳更多模型、更复杂场景、更严格治理要求所奠定的坚实基础。选择专业路由,就是选择了一条可控、可观、可持续的企业AI演进之路。