墨西哥医疗机构:AGIOne统一AI效能层驱动GPU利用率增长
当AI试点遍地开花,GPU利用率却低于20%,效率的"糖"正在变成成本的"毒"。
过去的两年,几乎每一家追求卓越的B2B企业,都在争相开启AI试点项目。但一个更棘手的问题正在浮出水面:如何让AI从"点状的成功",进化为"面状的能力"?
从金融到制造,从零售到医疗,跨行业组织正集体陷入一个尴尬的转折点——AI的增长速度,开始超越其承载基础设施的进化速度。
今天,我们通过墨西哥一家国家级医疗机构的真实实践,来拆解这个全球性难题的解题思路。他们的经验,或许正是你正在寻找的答案。
一、理想与现实:当AI"快跑"时,基础设施还"不会走"
医疗行业对AI的渴望毋庸置疑:更快的影像诊断、更精准的放射分析、更智能的患者服务。这家墨西哥医疗机构也不例外,他们率先迈出了勇敢的一步——针对不同的应用场景,独立部署了多个AI项目。
然而,这种"一个萝卜一个坑"的早期模式,很快演变成了一场运营噩梦:
- 资源利用率触目惊心:每个AI应用都拥有专属的硬件堆栈,导致GPU资源严重碎片化。实测显示,初始GPU利用率低于20%。各团队独立操作基础设施,重复建设问题突出,成本高昂。
- 扩容依赖硬件采购,响应缓慢:面对突发的诊断需求高峰,系统无法弹性伸缩。每一次扩容都意味着采购新硬件,而采购周期与医疗业务的实时性要求格格不入。
- 资本支出飙升,部署周期拉长:硬件重复投入导致CapEx急剧膨胀,新AI服务的上线速度却被硬件供应链牢牢卡住。
瓶颈,不再是AI模型的能力,而是交付和维持这种能力的方式。
二、破局之道:构建统一的"AI效能层"
该机构的IT负责人意识到,他们需要的不是另一个更聪明的算法,而是一个能统管所有算法、盘活所有硬件的"智能指挥官"。他们做出的核心转变是:摒弃"以应用为中心"的孤立部署,转向"以共享服务为中心"的统一AI运营平台。
这一平台的核心,是构建了一个全新的"AI效能层",实现了四大关键突破:
1. 资源池化,化碎片为整体
将散落在各团队手中的GPU资源"收归公有",形成一个共享计算池。哪个应用需要,就动态分配;用完后立即回收。碎片化容量被整合后,GPU利用率得到显著提升。
2. 异构纳管,保护既有投资
平台能够跨不同的GPU型号,将已有资产无缝纳入统一调度,避免推倒重来。
3. 模型聚合,多类LLM统一服务
平台上聚合了多种大语言模型——包括开源LLM、私有数据预训练模型、垂直领域模型及专用模型。前端应用无需关心背后调用的是哪一个,实现了模型层的统一抽象。
4. 混合云弹性,扩容不中断
当本地资源达到上限时,工作负载可自动扩展至云端GPU环境,整个过程实时完成,业务零中断。
从此,扩容不再依赖硬件采购的漫长等待。
三、运营之变:AI不是"部署"出来的,而是"运营"出来的
从"项目思维"转向"产品思维"的最后一块拼图,是运营流程的重塑。
该机构引入了一套完整的AI生命周期方法论,涵盖5个核心阶段:计划(Plan)→ 路由(Route)→ 执行(Execute)→ 验证(Validate)→ 调整(Adjust)。
其中,智能路由是关键突破。系统会根据三类维度自动决策工作负载的去向:
- 延迟要求:高实时性任务留在本地,批处理任务可走云端;
- 成本考量:在满足性能的前提下,自动选择性价比最优的路径;
- 数据敏感度:涉及患者隐私的数据严格留在本地合规环境,脱敏或低敏数据可弹性扩展。
这一机制让AI系统具备了Agentic Workflows能力——可以执行多步流程,在计划、行动、验证、调整的闭环中迭代。在医疗场景中,决策路径极少是线性的,这种能力尤为重要。
四、成果:从"成本负担"到"战略护城河"
经过这一系列变革,该机构的AI能力实现了质的飞跃:
- GPU利用率大幅提升:碎片化容量被整合进共享池后,硬件投资回报率显著改善(由低于20%起步,实现翻倍以上增长)。
- 部署周期显著缩短:新AI服务上线及运营变更的滚动周期(Rollout Time)从"月"压缩到"天",业务响应速度质的飞跃。
- 扩容不再受制于硬件采购:混合云弹性架构使得本地资源触及上限时可实时扩展至云端,且业务全程不中断。
- 数据治理与合规性强化:集中化控制台让监管变得简单可控,患者数据始终在合规边界内流转。
更重要的是,AI真正融入了这家医疗机构的血液——从一个需要被管理的"成本项目",变成了支撑核心诊断业务、不可或缺的战略能力。
以上为AGIOne在墨西哥交付的真实案例,有类似需求的伙伴,欢迎联系我们了解更多最佳实践。
结语:AI基础设施的"公用事业化"
这家墨西哥医疗机构的实践向我们揭示了一个清晰的趋势:企业AI竞争的下半场,拼的不是谁家的模型参数大,而是谁家的AI基础设施更"抗造"、更"灵活"、更"高效"。
模型的能力正在趋同,而规模化、持续化、韧性化的运营能力,正在成为决定成败的关键胜负手。
要实现这一转变,企业需要一套能够整合计算资源、抽象模型访问、自动化工作负载编排的智能底座。这正是 AGIOne 的核心能力——它帮助组织将碎片化的AI孤岛,转变为统一的、可扩展的、策略驱动的AI效能层,让企业能够稳健迈入AI Agent与持续决策系统深度嵌入核心业务的下一个时代。
AGIOne 能力简介
AGIOne 是一款面向企业级AI规模化运营的统一智能底座,整合模创(Model One)与算模方(Power One)两大核心模块,具备三大核心能力:
多模型统一服务治理能力:支持异构模型的统一接入、策略化路由、API网关与可观测管理,实现模型即服务(MaaS)的标准化交付与计量结算,降低多模型使用与运维成本。
异构算力统一调度能力:纳管多厂商、多型号智算资源,通过容器化调度与规格化管理,快速交付训练、推理及开发环境,提升算力利用率和运行效率。
模算一体化闭环协同能力:模型发布与算力部署深度联动,自动适配硬件与性能优化模板,形成从算力资源到模型服务输出的端到端闭环,支撑企业AI规模化运营的弹性、稳定与可控。
AGIOne 的目标,是让AI基础设施像水电一样成为企业的"公用效能工具",即取即用、按需付费、弹性扩展,助力企业专注基于AI的业务创新而非底层运维。
立即开启企业级AI规模化运营>>AGIOne — 模型即服务 + 算力即服务平台

关于我们
内容推荐
模型路由如何兼顾质量、延迟、可用性与成本?
每 Token 成本怎么计算?指标、公式与常见误区
企业AI平台安全框架:身份、租户、接口与审计
企业 AI 平台与 AI API Gateway 有什么区别?
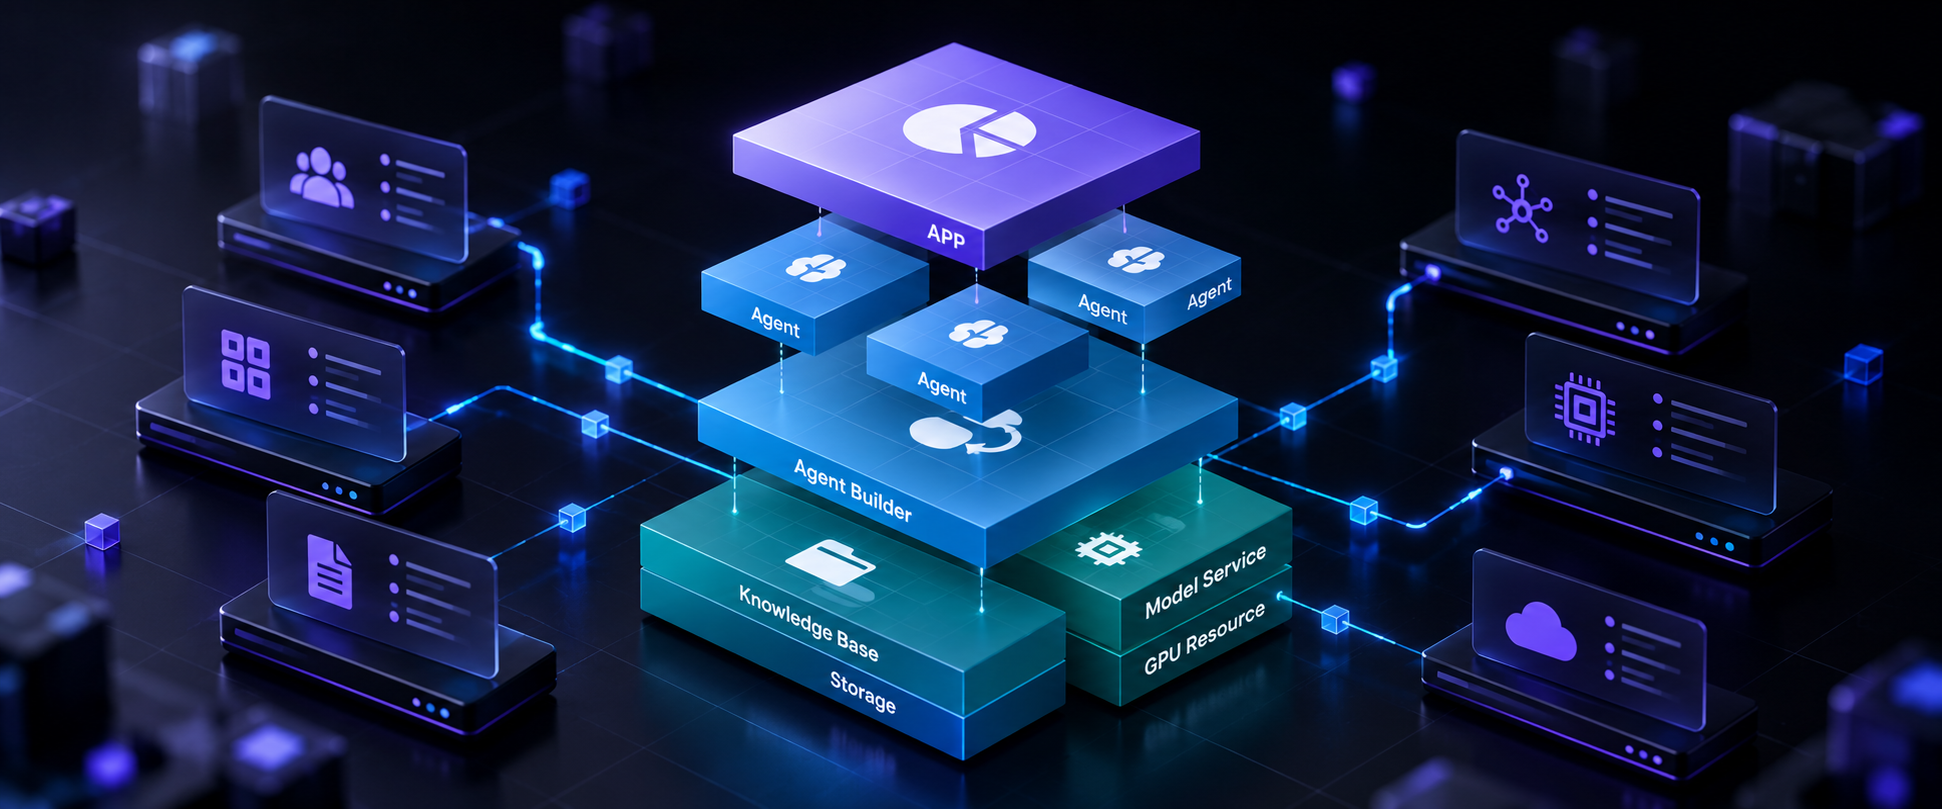
AGIOne 产品架构:模型服务、算力资源与运营治理如何协同
制造企业如何管理工厂、云端与边缘AI资源?
GPU资源池化最佳实践:提升企业AI计算效率的5个步骤
连Token 都有了中文名,企业 CIO 却还是最后一个知道公司在AI上花了多少钱?
私有化 AI 平台适合哪些企业?6 个判断条件


提交此表格即表示您同意万博智云将根据隐私政策处理您的个人信息。
