
买了 GPU、部署了模型、接通了 API,为什么算力业务仍然难以持续?当私有集群、公共算力平台和 Token 服务商开始提供模型服务,真正影响交付的,往往是资源调度、权限、计量、结算和服务稳定性之间能否连通。
浪潮人工智能研究院2026年一季度监测的全国智算中心 GPU 平均利用率约30%;中国信通院数据显示,2025年智能算力实际使用率约36.8%,超六成建成算力处于闲置状态。西部某千卡级智算中心案例显示,其上架率不足50%,已上架服务器实际利用率不足30%,年运营成本超过3000万元。上架率、GPU利用率和智能算力实际使用率分别反映不同环节,需要结合各自口径理解。
值得拆解的问题是:资源已经接入,为什么还不能稳定地交付服务?
三类算力拥有者,卡在不同的运营环节
企业私有集群和科研课题组的采购往往分散在不同部门。夜间或闲置期的资源无法共享,调用配额与成本分摊也没有统一机制,容易出现有的团队资源紧张、有的团队用不完的情况。
园区与地方公共算力平台需要同时管理多租户、服务额度和账单。硬件投入之后,仍需建立持续交付和精细化运营能力。
Token 服务商和 API 转发者则会逐渐遇到多模型选择、服务稳定性、复杂计费套餐与权限隔离需求。简单转发链路难以独立承接这些职责。
若按40%的上架率作为粗略的盈亏平衡假设,未达到这一水平的项目就可能面临覆盖完整成本的压力,实际盈亏还取决于采购成本、电价、租赁价格和运营方式。与此同时,部分头部集群依托低电价、精细调度和高效运营实现了较高的资源需求。同样拥有算力,不同运营方式带来的经营结果可能相差很大。
算力闲置需要结合资源结构、用户需求与运营能力分析,不能只看硬件规模。
算力运营平台需要连接的五项能力
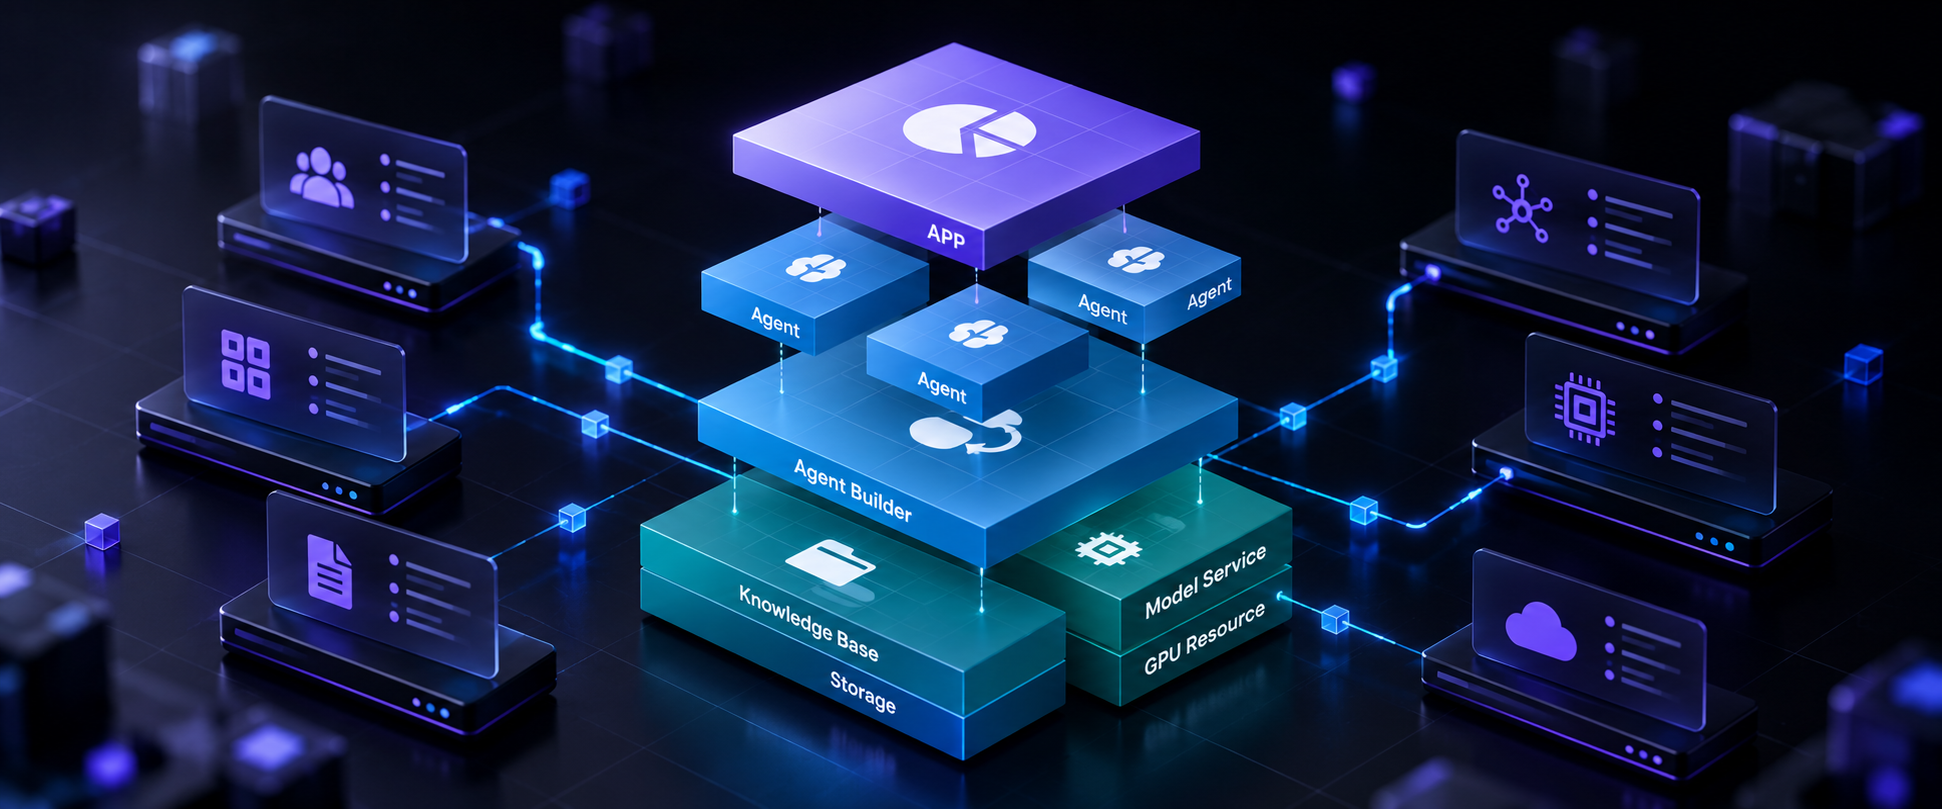
判断运营平台,关键在于资源侧和服务侧能否连接:底层投入了什么,上层交付了什么,谁在使用、消耗多少、运行情况如何,应能在同一套数据体系中解释。
1. 模型服务管理
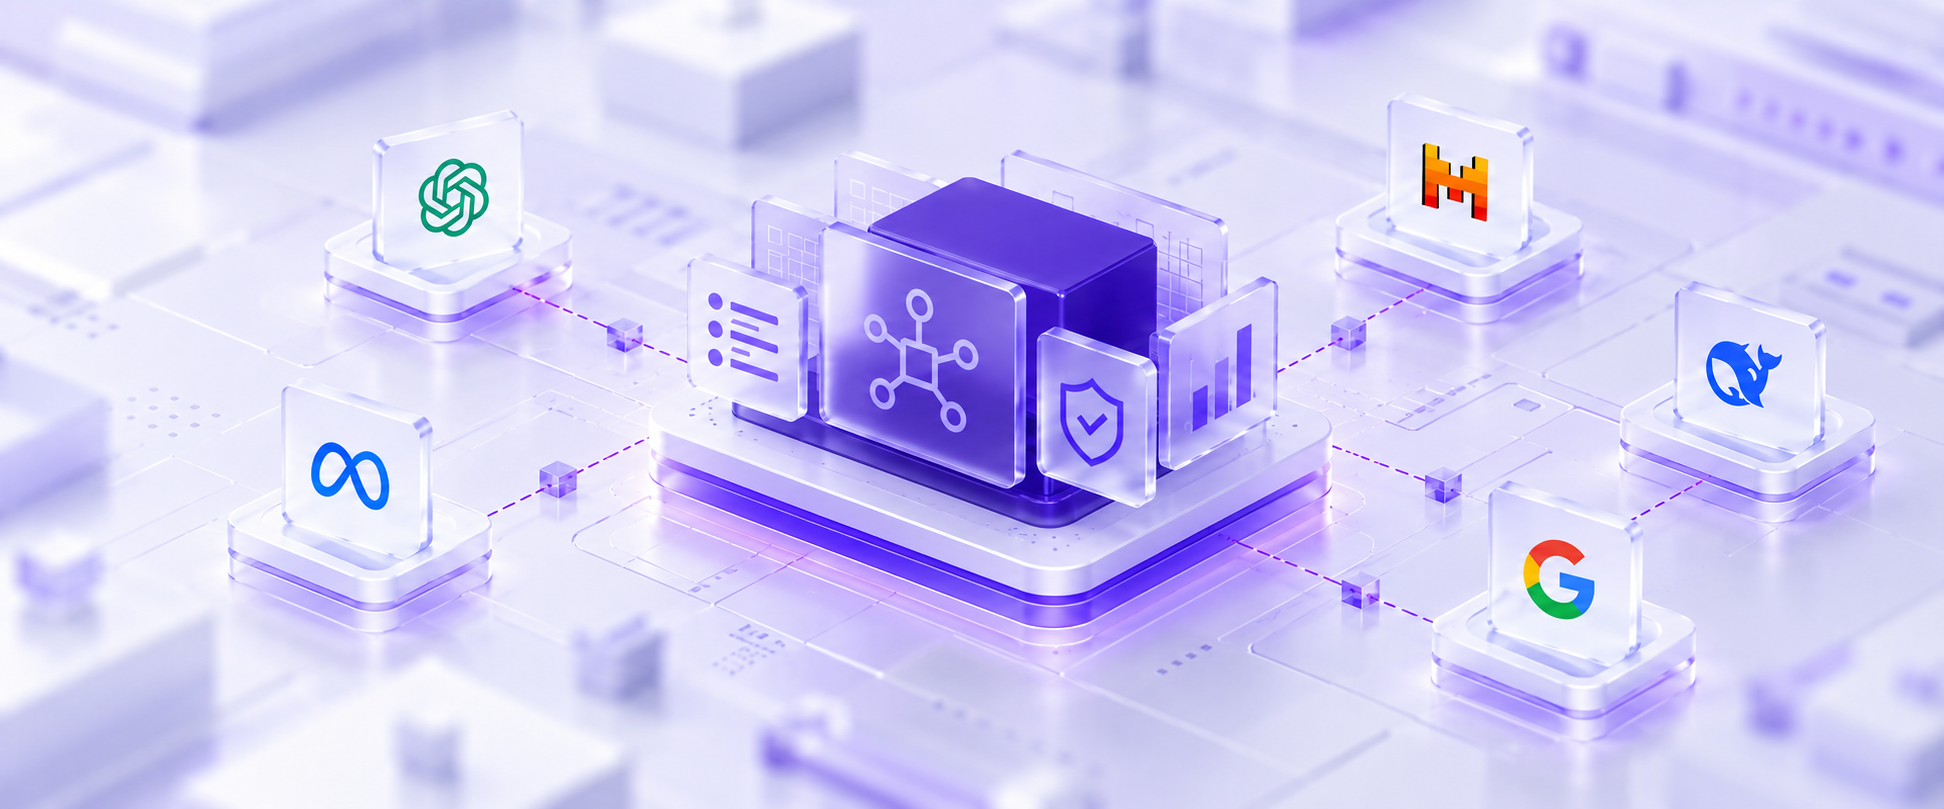
将自建模型、外部模型及异构算力环境中的模型组织成统一服务目录,打通部署、发布、授权与上下架流程。用户按服务调用,运营方将一次部署沉淀为可重复交付的能力。
2. 多租户与授权治理
围绕租户、项目、成员和角色建立管理体系,把服务可见性、模型白名单、项目预算、成员额度关联到业务主体。每一次调用有明确归属,后续才能归集用量、开展审计和处理账务。
3. 多维计量、额度与计费策略
围绕输入、输出、缓存 Token,以及调用次数、时长等维度统一计量口径,支持阶梯价、套餐、折扣与免费配额策略,并结合 RPM、TPM 限流管理使用边界。
模型消费还需与底层算力使用衔接。只看 GPU 利用率,无法完整解释上层服务的消耗与交付情况。
4. 账单、对账与结算
技术日志与客户、项目、价格和账期对应后,才能进入经营管理。账户流水、消费账单、对账与结算状态需要统一组织,商业服务商据此开展结算分润,企业与公共平台据此完成费用归集与成本分摊。
5. 服务连续性与运营观测
通过失败重试、请求切换、熔断摘流与限流机制支撑服务连续性,并将底层 GPU 利用率、负载与上层吞吐量、首字延迟、错误率连通,为故障排查和容量调整提供依据。
医疗机构案例:从分散建设走向统一运营
一家大型医疗机构在推进 AI 服务时遇到了类似问题。随着医学影像分析、放射分析和患者智能问答等服务增加,各科室分别采购硬件和部署模型,形成资源与运维孤岛:影像科夜间算力闲置,行政与研发部门却缺乏支持,IT 部门也难以统计全院真实 AI 投入产出。
该机构引入 AGIOne 后,将分散的异构算力组织成共享资源池,并建立统一模型服务与 Token 运营体系:
· 闲置时段资源调度给低优先级批处理任务,改善整体利用情况。
· 新业务调用现有模型 API 资源,减少重复购买专用硬件的需求。
· 各科室按实际 Token 消耗核算成本,管理层获得统一的运营视图。
从 API 调用到经营记录
模型服务能否持续经营,取决于调用背后的用户、权限、资源、计量、账单和服务保障能否形成完整链路。每一次调用只有变成可管理、可核算、可追溯的记录,才有条件支持后续的成本分摊、资源优化与服务运营。




.png)


